
Vom biologischen zum künstlichen Neuron
Neuronen sind die Nervenzellen aus den das Nervensystem besteht (zusammen mit Gliazellen). Das menschliche Gehirn enthält dabei ca. 90 Milliarden Nervenzellen.
Ein Neuron empfängt Signale von mehreren anderen Gehirnzellen. Diese "Erregungen" werden unterschiedlich gewichtet und aufsummiert und lassen - nur wenn ein bestimmtes Schwellenpotential überschritten wird - das Neuron nach dem "Alles oder Nichts"-Prinzip seinerseits "feuern". D.h. das Neuron erregt jetzt selbst alle Zellen, mit denen es über seine Nervenfasern verbunden ist.
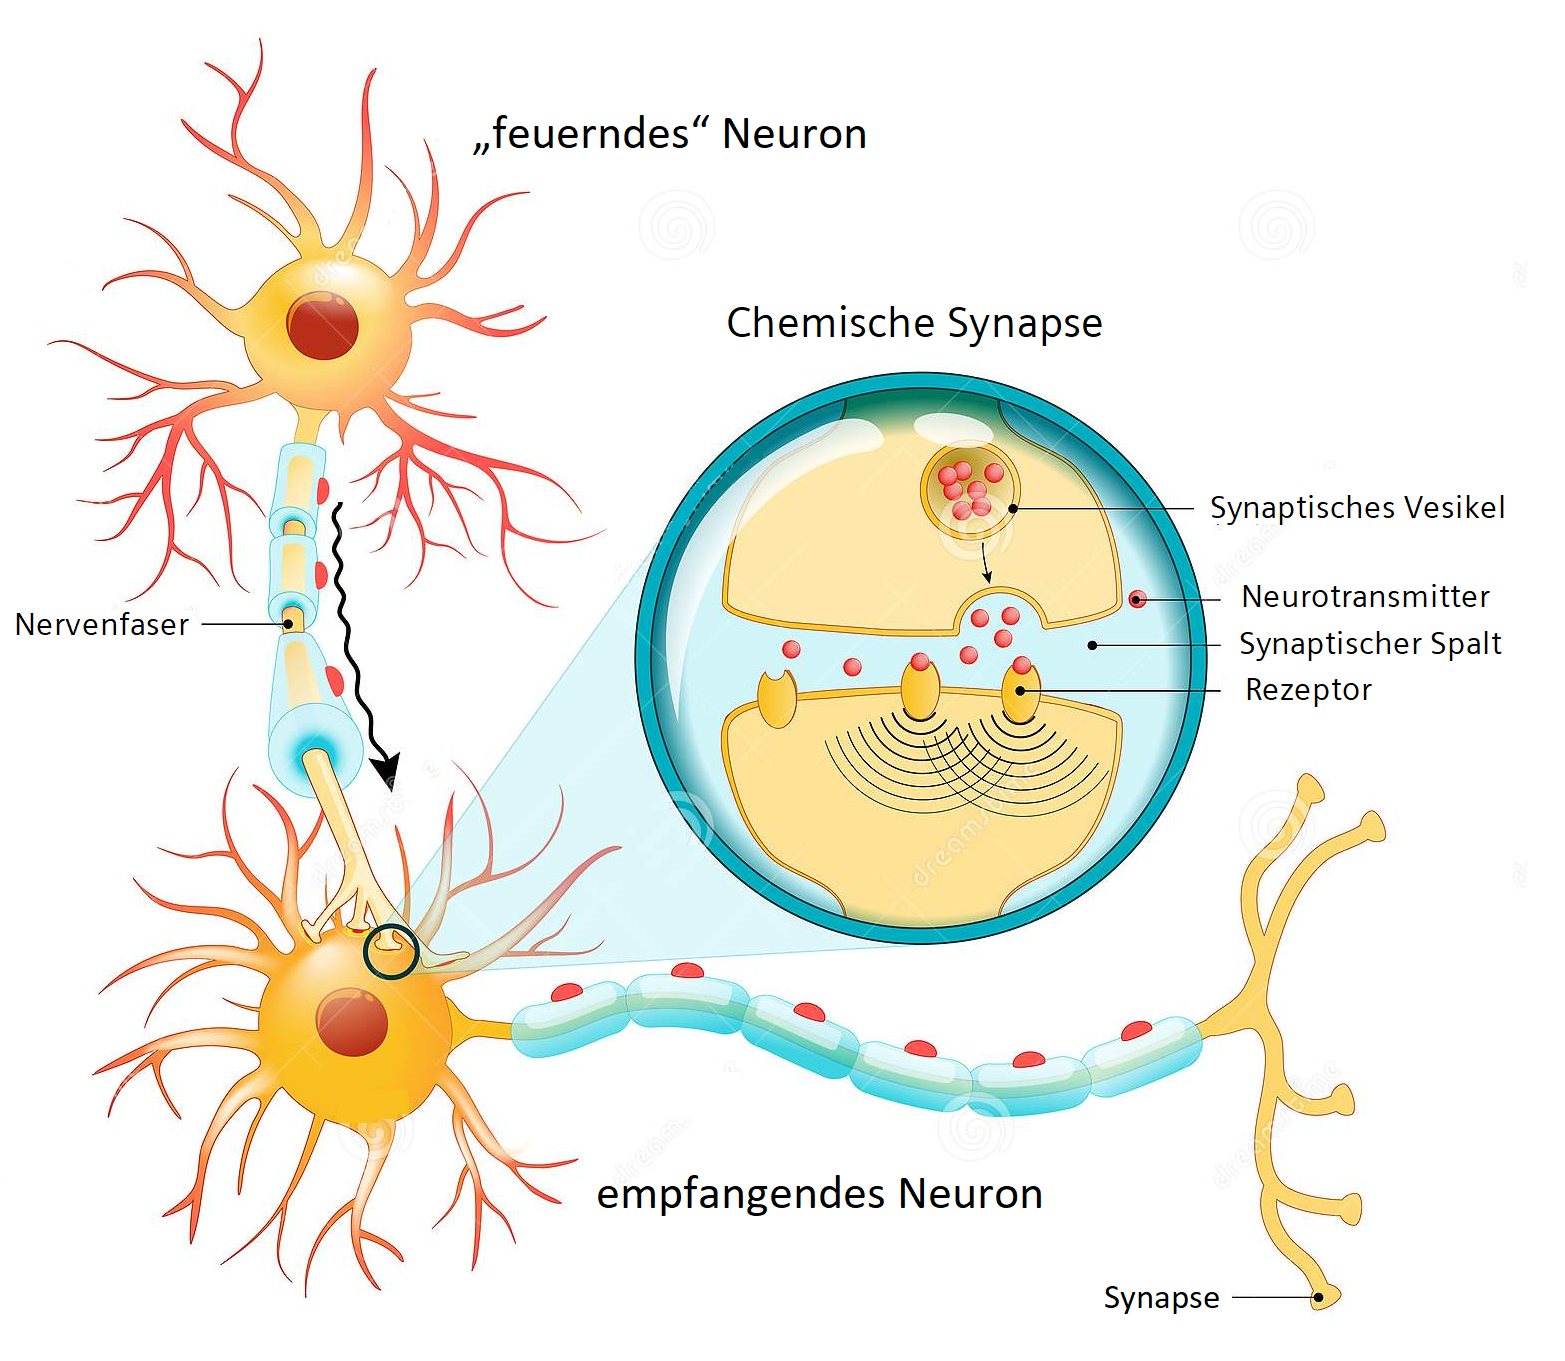
Natürliche Neuronen mit Synapse
https://nl.dreamstime.com/transmissie-van-het-zenuwsignaal-tussen-twee-neuronen-met-axon-en-synaps-close-up-een-chemische-neurale-mededeling-vectordiagram-image153760677 (bearbeitet, 20.02.2022)
Dabei spielen die Synapsen eine wichtige Rolle. Sie bezeichnen die Übergangsstellen an denen die Erregungen von einer Zelle auf eine andere übertragen werden. Überwiegend werden die Signale durch chemische Neurotransmitter über den synaptischen Spalt übertragen. Diese Synapsen selbst sind anpassungsfähig. Durch die Menge der chemischen Botenstoffe und andere Effekte kann die Effektivität dieser Schnittstellen durch seine Nutzung verstärkt oder abgeschwächt werden (vorhandenes oder fehlendes Training). Im menschlichen Gehirn befinden sich geschätzt 1 Billiarde Synapsen, also Nervenverbindungen.
Informationstechnisch lassen sich die vernetzten Neuronen stark vereinfacht nachbilden:
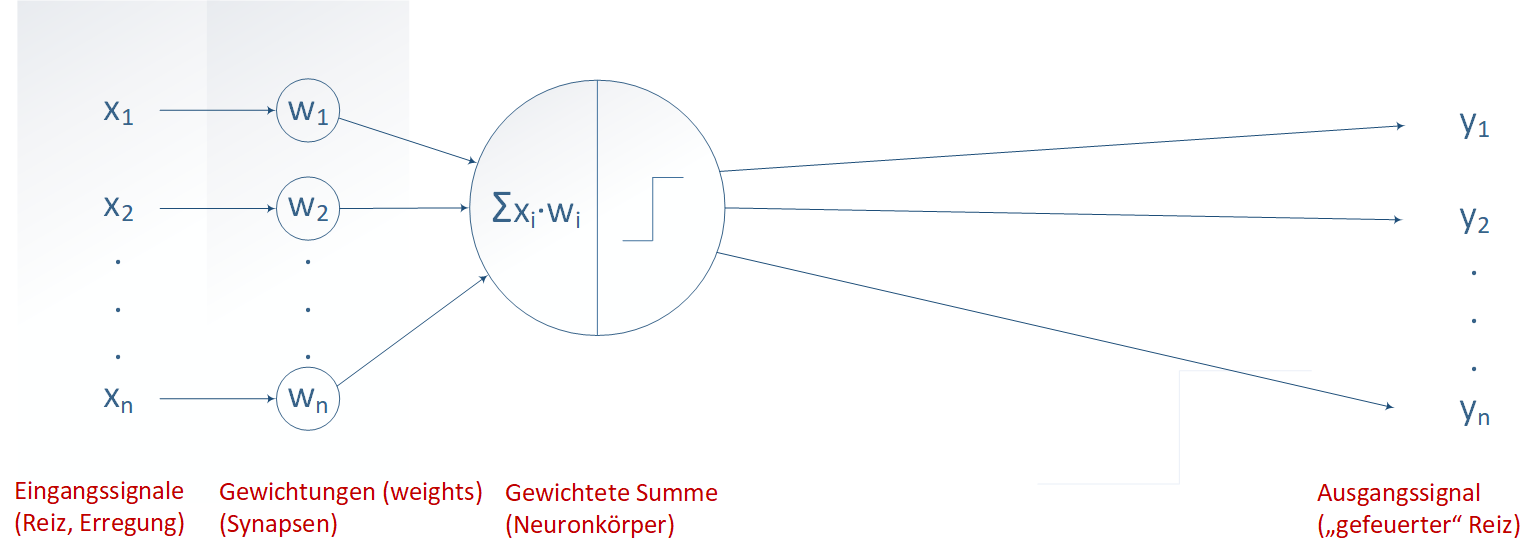
Künstliches Neuron
Ob das künstliche Neuron nun feuert oder nicht wird im Wesentlichen einzeln, also Neuron für Neuron berechnet. Im Gegensatz zum biologischen neuronalen Netz läuft das Aufsummieren der eingehenden und gewichteten Erregungen, in allen Neuronen des künstlichen neuronalen Netzes NICHT gleichzeitig also parallel sondern nacheinander ab.
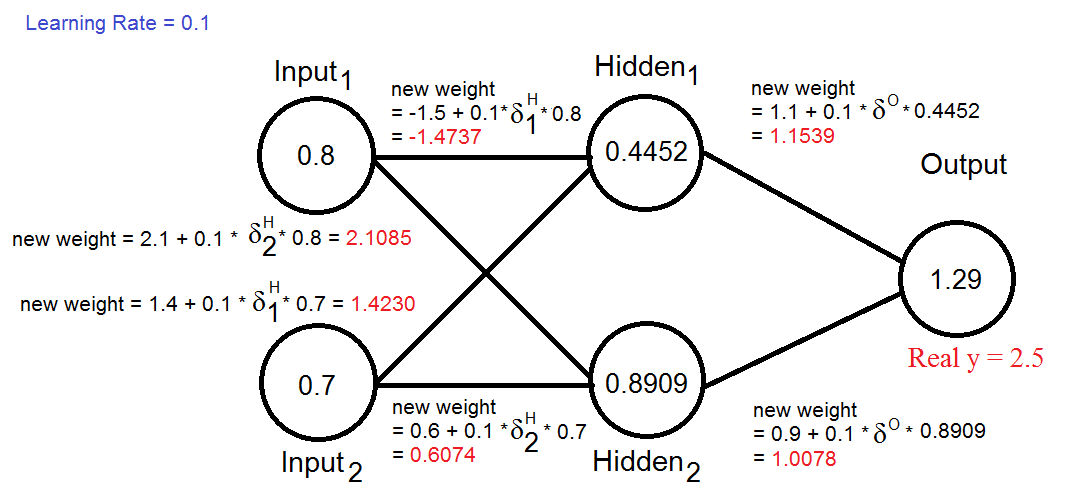
Gewichtung der Verbindungen
https://medium.com/@najeebnik21/activation-function-in-deep-learning-587e83d5a681 (17.02.2022)
Genauso wird dieses künstliche neuronale Netz schrittweise trainiert. Was bedeutet, dass auch für den Lernprozess die Gewichtung der der eingehenden Signale Neuron für Neuron zeitlich nacheinander neu berechnet werden muss.
CPU, GPU und TPU
Echte Parallelverarbeitung durch viele Rechenkerne beschleunigen sowohl der Verarbeitungs- als auch Trainingsprozess sehr stark. Hier sind Graphic Processing Units (GPUs) sehr stark im Vorteil, denn sie verfügen über Hunderte bis Tausende Cores. Sie sind wegen der vielen graphische Berechnungen auf Durchsatz und nicht auf hohe Verarbeitungsgeschwindigkeit einzelner Befehle wie bei den Central Processing Units (CPUs) optimiert.
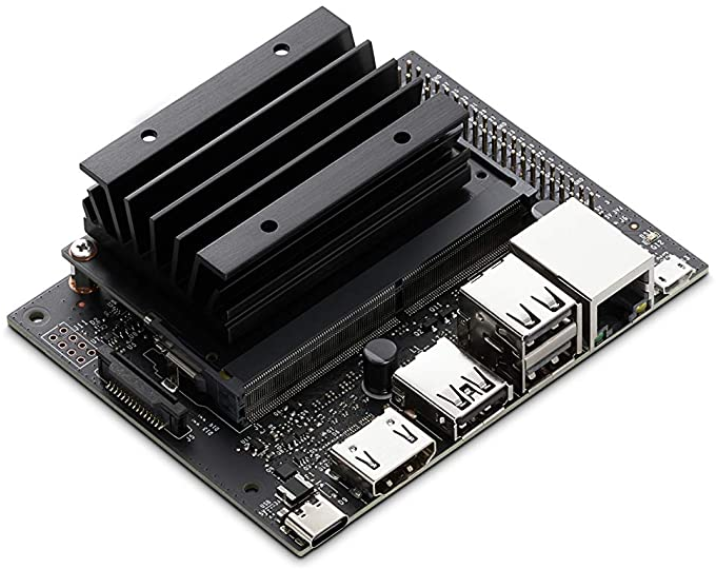
Jetson Nano von Nvidia mit 128-Kern GPU
Der Jetson Nano ist resourcensparender Einplatinen-Rechner mit 128-Kern GPU für KI-Projekte. Die CPU-Leistung ist in etwa mit des Rasperry Pi vergleichbar.
https://developer.nvidia.com/embedded/dlc/jetson-nano-system-module-datasheet
Tensor Processing Units (TPUs) sind dagegen anwendungsspezifische Chips (ASICs), die speziell für die Anforderungen des maschinellen Lernens entworfen werden. Da sie nicht nur Parallelverarbeitung durch viele "Compute Units" unterstützen, sondern auch die notwendigen Algorithmen wie z.B. Matrizenrechnung oder optimierte Fließkomma-Berechnungen realisieren, sind Sie ganz besonders leistungsfähig.
Die von Google entwickelten TPUs wurden speziell für die Softwaresammlung TensorFlow des Unternehmens entworfen. Diese TPUs sind die Basis für alle Google Services, die maschinelles Lernen einsetzen.