
Konvergenz und Divergenz
Bei der Entwicklung des Codes zur Aufgabe: Gewicht anpassen musste experimentell die Schrittweite zur Annäherung an die Zielvorhersage eingestellt werden (Lernrate). Wenn diese zu groß eingestellt wird, dann konvergieren (spätlat. sich annähern) die Werte nicht, sondern sie explodieren geradezu. Man spricht dann von Divergenz als dem Gegenteil von Konvergenz.
Konvergenz
In den Codebeispielen, wurde die Lernrate mittels des Parameters alpha eingestellt:
weight = weight - weight_delta * alpha # neues Gewicht einstellen = lernen mit eingestellter Lernrate
alpha richtig eingestellt, dann konvergiert das KNN: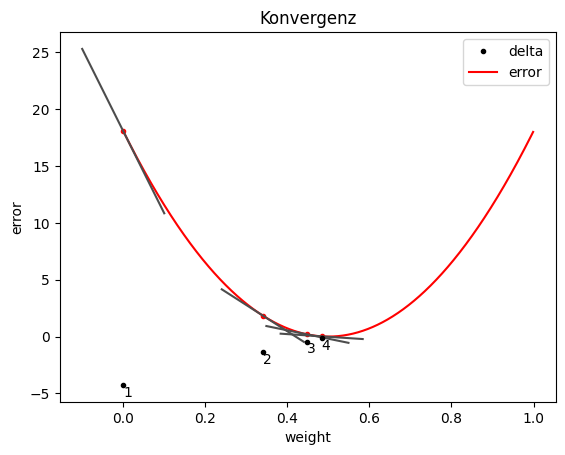
Konvergenz
Die nummerierten Punkte kennzeichnen die Reihenfolge der Lernschritte. Der Gradientenabstieg verläuft hier stetig. Die Steigung wird immer kleiner. Allerdings kann dieser Prozess infolge eines zu klein gewählten alpha auch zu lange dauern.
Im folgenden Diagramm ist alpha etwas zu groß gewählt. Das KNN konvergiert zwar noch, aber die Lernschritte gehen immer etwas über das Ziel hinaus. Auch dies kann zu lange dauern.
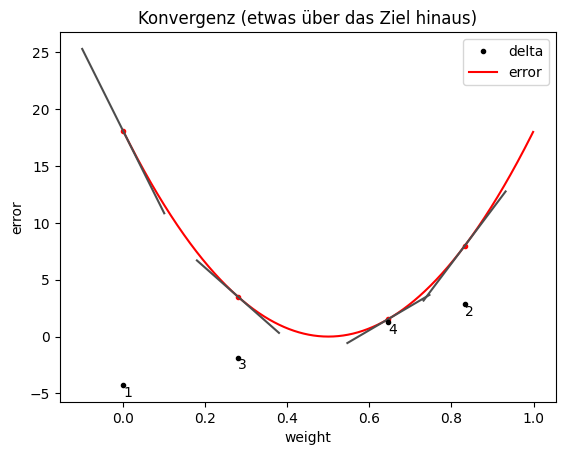
Konvergenz doch der Lernschritt geht etwas über das Ziel hinaus.
Der Gradient steigt zwar ab, aber seine Richtung wechselt ständig.
Divergenz
Im letzten Diagramm wird ein zu großes alpha veranschaulticht. Das KNN divergiert:
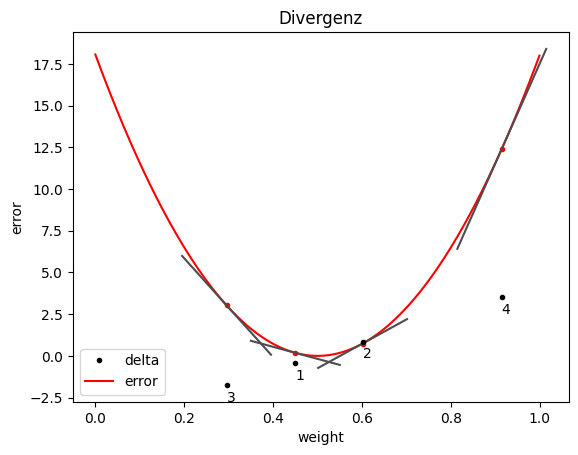
Divergenz
Der Gradient wechselt stets seine Richtung und wird dabei größer. Er schaukelt sich regelrecht auf.
Zum ausprobieren: https://github.com/ateachment/Moodle-KI/blob/main/KonvergenzDivergenz.ipynb (26.09.2022)