
Exkurs: Statistische Grundbegriffe
Statistik „ist die mathematische Lehre von Methoden zum Umgang mit quantitativen Informationen“. In der IT bedeutet das, zu versuchen aus Daten Theorien abzuleiten.
(Wem die folgenden Ausführungen zu abstrakt sind, stelle sich einfach vor, man segelt in einem unbekannten Gewässer und die folgenden Werte sind Windstärken an aufeinander folgenden Tagen.)
Arithmetischer Mittelwert = Durchschnitt
Beispiel einer Datenmenge:
\( M= \{ 10,1,8,4,5,2,8,3\} \)
Anzahl der Elemente:
\( n= 8 \)
Arithmetisches Mittel (engl. mean):
\( \bar{x} = \frac{1}{n} \sum\limits_{i=0}^{n}{ x_i} = \frac{10+1+8+4+5+2+8+3}{8}= 5 \)
Das arithmetische Mittel sagt noch nichts über die Streuung der Werte aus, also wie die Werte verteilt sind.
Folgende Menge hat den gleichen arithmetischen Mittelwert, aber die Werte sind weniger weit verteilt. Sie streuen weniger:
\( M_2= \{ 4,5,6,7,6,5,4,3\} \)
\( \bar{x_2} = \frac{4+5+6+7+6+5+4+3}{8}= 5 \)
Das arithmetische Mittel alleine reicht also nicht, um eine Aussage über die Verteilung der Werte zu machen.
Varianz
Die Varianz (lat. variantia = Verschiedenheit) ist ein Maß für die Streuung.
Die Abweichung eines Wertes zum Mittelwert ist:
\( x - \bar{x} \)
Um die Abweichung aller Werte zum Mittelwert zu erhalten,
müssten alle Abweichung addiert werden. Dabei würden sich jedoch die positiven
und negativen Werte aufheben. Daher wird jede
einzelne Abweichung quadriert und erhält so positive Quadrate. Aus der Summe aller quadrierten Abweichungen bildet man dann den
Mittelwert. Damit erhält man die Varianz als ein Maß für die Abweichungen aller Beobachtungswerte:
\( s^2 = \frac{1 }{n}\sum\limits_{i=0}^{n}{ (x_i-\bar{x})^2}\\ =\frac{ (10-5)^2 +(1-5)^2+(8-5)^2+(4-5)^2+(5-5)^2+(2-5)^2+(8-5)^2+(3-5)^2}{8}\\ =\frac{73 }{8} =9,125 \)
Ein Vergleich mit der 2. Datenmenge ergibt einen kleineren Wert, weil die Werte weniger streuen:
\( {s_2}^2 =\frac{(4-5)^2 +(5-5)^2+(6-5)^2+(7-5)^2+(6-5)^2+(5-5)^2+(4-5)^2+(3-5)^2}{8}\\ =\frac{12 }{8}=1,5 \)
Viele Daten habent eine Einheit, z. B. Meter (m). Die Varianz ist eine Summe von Quadraten, daher hat sie als Einheit das Quadrat der Einheit, z. B. m2. Um wieder auf die ursprüngliche Einheit zu gelangen zieht man die Wurzel:
Standardabweichung
Die Standardabweichung wird berechnet, indem die Wurzel aus der Varianz gezogen wird:
\( s = \sqrt{ s^2 }= \sqrt{\frac{1 }{n}\sum\limits_{i=0}^{n}{ (x_i-\bar{x})^2}}\\ \)
\( s= \sqrt{ s^2 }\\ = \sqrt{9,125}=2,83 \)
Für den 2. Datensatz gilt:
\( s_2= \sqrt{1,5}=1,22 \)
Die Standardabweichung ist ein Maß dafür, wie hoch die Aussagekraft des Mittelwertes ist:
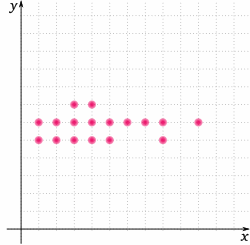
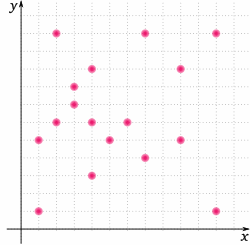
Kleine und große Standardabweichung
https://matheguru.com/stochastik/standardabweichung.html (09.12.2022)
Bei einer kleinen Standardabweichung liegen alle Werte nahe am Mittelwert.
Wenn die Standardabweichung groß ist, liegen die Werte weit um den Mittelwert gestreut.
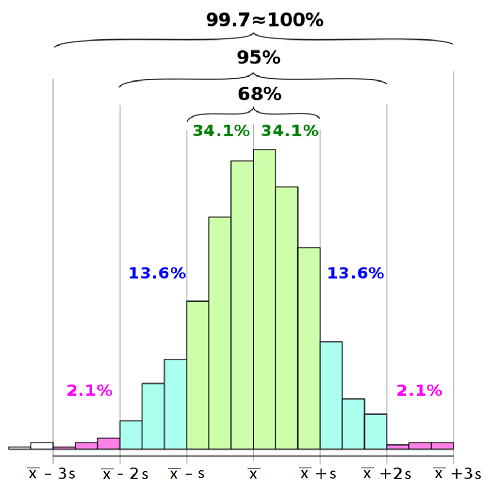
Annähernd normal verteilter Datensatz (Gaußsche Normalverteilung)
https://en.wikipedia.org/wiki/68%E2%80%9395%E2%80%9399.7_rule (09.12.2022)
Bei einem annähernd normalen Datensatz machen die Werte innerhalb der Standardabweichung etwa 68 % des Datensatzes aus.
Quartile
Quartile (lat. Viertel) teilen eine Datenreihe in Viertel auf.
Sortiert man die Datenmenge nach Größe und unterteilt sie in 4 gleich große Abschnitte mit jeweils der (möglichst) gleichen Anzahl von Werten.
1. Quartil: Q1 = 2,5
2. Quartil: Q2 = 4,5
3. Quartil: Q3 = 8
Etwa 25% aller geordneten Werte sind kleiner als das 1. Quartil.
Etwa 50% aller geordneten Werte sind also kleiner als das 2. Quartil.
Etwa 75% aller geordneten Werte sind kleiner als das 3. Quartil.
Quartilsabstand
Zwischen dem 1. und 3. Quartil liegen liegen folglich 50% aller Werte. Dieser Bereich wird auch Quartilsabstand genannt.
\( Q_A = Q_3 - Q_1 \)
Dadurch haben wir ein Maß dafür, wie weit die meisten Werte voneinander entfernt sind.
\( Q_A = 8 - 2,5 = 5,5 \), d.h. 50 % aller Werte liegen zwischen 2,5 und 8. Sie sind damit maximal 5,5 auseinander.
Für den 2. Datensatz ergibt sich:
\( M_2= \{ 3,4\ |\ 4,5\ |\ 5,6\ |\ 6,7\} \)
1. Quartil: Q1 = 4
2. Quartil: Q2 = 5
3. Quartil: Q3 = 6
\( Q_A = 6 - 4 = 2 \), d.h. 50 % der Werte liegen nur maximal 2 auseinander.
Die Streuung lässt sich also auch mit der Einteilung des Datensatzes in Quartile abschätzen.