
NLP-basierte Suchmaschine
Problem
Normalerweise basiert eine Suche innerhalb eines Webauftritts auf SQL-Datenbankabfragen, um Suchworte innerhalb des Webauftritts einzelnen Seiten zuordnen zu können.
Beispiel: Codeauszug der Suche innerhalb einer WordPress-Installation:
$wild = '%';
$find = 'only 43% of planets';
$like = $wild . $wpdb->esc_like( $find ) . $wild;
$sql  = $wpdb->prepare( "SELECT * FROM $wpdb->posts WHERE post_content LIKE %s", $like );
Quelle: wpdb::esc_like() | Method | WordPress Developer Resources (10.03.2022)
Nun haben Suchmaschinen natürlich keinen Zugang zu den Datenbanken der Internet Service Provider. Wie also können Suchworte mit Webseiten abgeglichen werden?
Lösungsansatz
Web Crawler
Suchmaschinen müssen daher zwangsläufig die Webseiten selbst lesen: Sogenannte Internet-Robots oder kurz Bots sind Programme die selbstständig Internetlinks folgen und hier für die Suchmaschinen-Anbieter die Inhalte auslesen und übertragen. Sie heißen auch "Crawler", weil sie quasi durch das Internet kriechen (engl. to crawl). Das automatisierte Auslesen von Webseiten wird auch als Web Scraping (kratzen = engl. to scrape) bezeichnet.
Natural Language Processing NLP
Die von den Bots übertragenen Webseiteninhalte müssen aufbereitet und dann abgespeichert werden. Die großen Suchmaschinen-Anbieter bereiten die Texte mit Hilfe von Natural Language Processing auf, z.B.:
- Es werden unrelevante Wörter (und, zu, dem, mein, ich ..) entfernt.
- Die Häufigkeit aller Wörter im gesamten Wortschatz wird ermittelt und das Gesamtvokabular nach Vokabelhäufigkeit sortiert
- Das Auftreten der Worte einer Seite wird damit abgeglichen und als Zahlenreihe (Vektor) abgespeichert.
- Die Relevanz der Worte einer Seite wird entsprechend gewichtet. (Worte einer Seite, die in vielen anderen Seiten vorkommen sind für die Suche weniger relevant.)
- Alle Webseiten überhaupt ergeben jeweils eine Zahlenreihe die zusammen als Bag of Words bezeichnet wird (Array). Die zu einer Zeile dazugehörige Internetadresse wird natürlich auch gespeichert.
Es ist davon auszugehen, dass keine herkömmlichen relationalen Datenbanken verwendet werden. Die Datenmenge ist für eine DB viel zu groß. SQL-Abfragen würden zu lange dauern.
Quelle: Welche Datenbank verwendet Google? (qastack.com.de) (10.03.2022)
Der Vergleich erfolgt danach:
- Die Suchworte werden ebenso mit den gleichen Methoden des NLP mathematisch aufbereitet und die sich so ergebende Zahlenreihe wird mit allen anderen Zahlenreihen der Bag of Words mit mathematischen Methoden verglichen (Cosinus-Vergleich von Vektoren).
- Diejenigen Zahlenreihen aus der Bag of Words mit den größten Ähnlichkeiten werden ermittelt und die entsprechenden Links dazu ausgegeben.
Demonstration: NLP-Suche über 4 Seiten
Dieses Verfahren wird hier beispielhaft angewandt:
Die 4 Webseiten sind auf github gehostet: https://ateachment.github.io/nlp-demo/index.html
Der kommentierte Code steht als Jupyter-Notebook bereit: https://gist.github.com/ateachment/7d3c6893b1e6a3b38b92e86ce7a94d20
Je nach Plattform müssen zuvor bestimmte Libraries installiert werden, z.B.
pip install requests
pip install bs4
pip install html5lib
Web Crawling
Zunächst ruft der Bot bzw. der Crawler eine Webseite aufgerufen und mit Hilfe Python-Bibliothek Beautiful Soup (HTML Parser) werden, HTML-Tags herausgefiltert, relevanter Text erfasst und dann rekursiv den Links die auf dieser Seite enthalten sind, gefolgt. So wühlt sich der Crawler so durch alle verlinkten Webseiten.
Es muss dabei verhindert werden, dass die Rekursion zu Endlosschleifen führt. Daher wird die Rekursionstiefe überwacht und auch Seiten kein 2. Mal durchlaufen.
# HTTP-Anfragen an Webseiten senden (zum Crawlen)
import requests

# HTML-Dokumente parsen und Inhalte extrahieren
from bs4 import BeautifulSoup

# URLs korrekt zusammensetzen und analysieren (z. B. relative Links)
from urllib.parse import urljoin, urlparse

# NumPy wird für numerische Berechnungen und Vektor-/Matrixoperationen verwendet
import numpy as np

# ----------------------------
# NLP-Bibliotheken
# ----------------------------

# Natural Language Toolkit (Grundlage für Textverarbeitung)
import nltk

# Deutsche Stopwörter (z. B. "und", "der", "die")
from nltk.corpus import stopwords

# Zerlegung eines Textes in einzelne Wörter (Tokenisierung)
from nltk.tokenize import word_tokenize

# Deutscher Snowball-Stemmer (Wortstammreduktion)
from nltk.stem.snowball import GermanStemmer

# Stemmer-Objekt erzeugen
stemmer = GermanStemmer()


# ----------------------------
# Lemmatisierung mit HanTa
# ----------------------------

# Installation der HanTa-Bibliothek (Hanover Tagger)
# Führt Wörter auf ihre Grundform (Lemma) zurück
!pip install HanTa

# Import des HanoverTagger
from HanTa import HanoverTagger as ht


def crawl_recursive(url, base_domain, visited=None, results=None, depth=0, max_depth=10):
    """
    Rekursiver Webcrawler.

    Parameter:
    url          : Start- oder Ziel-URL, die gecrawlt werden soll
    base_domain  : Domain-Beschränkung (z. B. ateachment.github.io)
                   → verhindert, dass externe Seiten gecrawlt werden
    visited      : Menge (set) bereits besuchter URLs
                   → verhindert Endlosschleifen
    results      : Dictionary zur Speicherung der gecrawlten Inhalte
                   → {url: textinhalt}
    depth        : Aktuelle Rekursionstiefe
    max_depth    : Maximale Tiefe, um das Crawling zu begrenzen
    """

    # Initialisierung beim ersten Funktionsaufruf
    if visited is None:
        visited = set() # speichert bereits besuchte Seiten
    if results is None:
        results = []    # speichert URL → extrahierter Text

    # Abbruchbedingungen
    # 1. Maximale Tiefe erreicht
    # 2. URL wurde bereits besucht
    if url in visited:
        return results

    if depth > max_depth:
        return results

    print("  " * depth + "Crawling:", url)

    # URL als besucht markieren
    visited.add(url)

    try:
        # Browser vortäuschen
        headers = {<span style="background-color: #fff0f0;">"User-Agent"</span>: <span style="background-color: #fff0f0;">"Mozilla/5.0"</span>}
        # HTML-Seite abrufen
        r = requests.get(url, headers=headers, timeout=5)
        r.encoding = "utf-8"
    except Exception as e:
        print("Fehler:", e)
        return results

    # HTML parsen
    soup = BeautifulSoup(r.text, "html.parser")

    # ---- reinen Text extrahieren (h1, h2, p) ----
    h1 = " ".join(h.get_text(strip=True) for h in soup.find_all("h1"))
    h2 = " ".join(h.get_text(strip=True) for h in soup.find_all("h2"))
    p  = " ".join(p.get_text(strip=True) for p in soup.find_all("p"))


    # einfach werten
    text = h1 + " " + h2 + " " + p
    # Überschriften künstlich verstärken
    # text = (h1 + " ") * 3 + (h2 + " ") * 2 + p

    results.append((url, text))

    # ---- Links rekursiv verfolgen ----
    for link in soup.find_all("a"):
        href = link.get("href")
        if not href:
            continue
        # Relative Links in absolute URLs umwandeln
        full_url = urljoin(url, href)
        parsed = urlparse(full_url)

        # Nur interne Links (innerhalb derselben Domain bleiben)
        if parsed.netloc == base_domain:
            # Funktion ruft sich selbst auf
            crawl_recursive(full_url, base_domain,
                            visited, results,
                            depth + 1, max_depth)

    return results

start_url = "https://ateachment.github.io/nlp-demo/index.html"
base_domain = "ateachment.github.io"

data = crawl_recursive(start_url, base_domain)

documents = []
urls = []

for url, text in data:
    urls.append(url)
    documents.append(text)
    print("\n", url, "\n", text)

print("\nAnzahl gecrawlter Seiten:", len(documents))
In diesem Demo wird so der Text von 4 Webseiten erfasst:
 https://ateachment.github.io/nlp-demo/index.html
 Informatik NLP-Suchmaschinen-Demonstration Diese Webseite enthält drei thematische Unterseiten zur Demonstration einer NLP-basierten Suchmaschine.

 https://ateachment.github.io/nlp-demo/ki.html
 Informatik Künstliche Intelligenz Künstliche Intelligenz ist ein Teilgebiet der Informatik. Maschinelles Lernen ist eine zentrale Methode der künstlichen Intelligenz. Neuronale Netze werden im Bereich Deep Learning eingesetzt. Künstliche Intelligenz findet Anwendung in Medizin, Industrie und Forschung. Zurück zur Übersicht

 https://ateachment.github.io/nlp-demo/anaconda.html
 Informatik Installation von Anaconda Anaconda ist eine Python-Distribution für Data Science. Die Installation von Anaconda erfolgt über ein Installationsprogramm. Anaconda enthält Python, Jupyter Notebook und viele wissenschaftliche Bibliotheken. Nach der Installation kann Anaconda über den Navigator gestartet werden. Zurück zur Übersicht

 https://ateachment.github.io/nlp-demo/datenbanken.html
 Informatik Relationale Datenbanken Relationale Datenbanken speichern strukturierte Daten. SQL wird verwendet, um Abfragen in Datenbanken durchzuführen. Tabellen bestehen aus Zeilen und Spalten. SQL ermöglicht Insert, Update und Select Operationen. Zurück zur Übersicht
Natural Language Processing NLP
NLP-Vorverarbeitung
Ausgangstext (hier: index.html):
Informatik NLP-Suchmaschinen-Demonstration Diese Webseite enthält drei thematische Unterseiten zur Demonstration einer NLP-basierten Suchmaschine.
1. Tokenisierung (in Liste überführen)
["Informatik", "NLP-Suchmaschinen-Demonstration", "Diese", "Webseite", "enthält", "drei", "thematische", "Unterseiten", "zur", "Demonstration", "einer", "NLP-basierten", "Suchmaschine"]
2. Lemmatisierung (mit HanTa auf die Grundformen zurückführen)
["Informatik", "NLP-Suchmaschinen-Demonstration", "Diese", "Webseite", "enthalten", "drei", "thematisch", "Unterseite", "zu",
 "Demonstration", "eine", "NLP-basiert", "Suchmaschine"]
3. Kleinschreibung
["informatik", "nlp-suchmaschinen-demonstration", "diese", "webseite", "enthalten", "drei", "thematisch", "unterseite", "zu", "demonstration", "eine",
 "nlp-basiert", "suchmaschine"]
4. Entfernen nicht-alphabetischer Tokens (isalpha entfernt auch Worte mit Bindestrich)
["informatik", "diese", "webseite", "enthalten", "drei", "thematisch", "unterseite", "zu", "demonstration", "eine", "suchmaschine"]
5. Stopword-Entfernung (z.B. "diese", "zu", "eine", ...)
["informatik", "webseite", "enthalten", "drei", "thematisch", "unterseite", "demonstration", "suchmaschine"]
6. Stemming
["informat", "webseit", "enthalt", "drei", "themat", "unterseit", "demonstration", "suchmaschin"]
def process_text(text):

    # 1. Tokenisierung
    tokens = word_tokenize(text, language="german")

    processed_tokens = []

    for word in tokens:
        # 2. Nur alphabetische Wörter betrachten
        if not word.isalpha():
            continue

        # 3. Lemmatisierung
        lemma = hannover.analyze(word)[0]

        # 4. Kleinschreibung
        lemma = lemma.lower()

        # 5. Stopwords entfernen
        if lemma in stop:
            continue

        # 6. Zusätzliches Stemming
        stem = stemmer.stem(lemma)

        processed_tokens.append(stem)

    return processed_tokens

processed_docs = [process_text(doc) for doc in documents]
processed_docs
[['informat', 'webseit', 'enthalt', 'drei', 'themat', 'unterseit', 'demonstration', 'suchmaschin'],
['informat', 'kunstlich', 'intelligenz', 'kunstlich', 'intelligenz', 'teilgebiet', 'informat', 'maschinell', 'lern', 'zentral', 'method', 'kunstlich', 'intelligenz', 'neuronal', 'netz', 'bereich', 'deep', 'learning', 'einsetz', 'kunstlich', 'intelligenz', 'find', 'anwend', 'medizin', 'industri', 'forschung', 'zuruck', 'ubersicht'],
['informat', 'installation', 'anaconda', 'anaconda', 'data', 'scienc', 'installation', 'anaconda', 'erfolg', 'installationsprogramm', 'anaconda', 'enthalt', 'pytho', 'jupyt', 'notebook', 'wissenschaft', 'bibliothek', 'installation', 'anaconda', 'navigator', 'start', 'zuruck', 'ubersicht'],
['informat', 'relational', 'datenbank', 'relational', 'datenbank', 'speich', 'strukturi', 'datum', 'sql', 'verwend', 'abfrag', 'datenbank', 'durchfuhr', 'tabell', 'besteh', 'zeil', 'spalt', 'sql', 'ermog', 'insert', 'updat', 'select', 'operation', 'zuruck', 'ubersicht']]
Durch diese Maßnahmen wird die Datenmenge bereits erheblich reduziert.
Wort-Häufigkeit bestimmen (Bag Of Words vorbereiten)
Der nächste Schritt besteht darin, die Häufigkeit aller Worte des gesamten Wortschatzes zu bestimmen:
from collections import Counter

all_words = []
for doc in processed_docs:
    all_words.extend(doc)

word_freq = Counter(all_words)
word_freq
Counter({'informat': 5, 'webseit': 1, 'enthalt': 2, 'drei': 1, 'themat': 1, 'unterseit': 1, 'demonstration': 1, 'suchmaschin': 1, 'kunstlich': 4, 'intelligenz': 4, 'teilgebiet': 1, 'maschinell': 1, 'lern': 1, 'zentral': 1, 'method': 1, 'neuronal': 1, 'netz': 1, 'bereich': 1, 'deep': 1, 'learning': 1, 'einsetz': 1, 'find': 1, 'anwend': 1, 'medizin': 1, 'industri': 1, 'forschung': 1, 'zuruck': 3, 'ubersicht': 3, 'installation': 3, '<a class="autolink" title="Anaconda" href="https://moodle.eick-at.de/mod/page/view.php?id=1139">anaconda</a>': 5, 'data': 1, 'scienc': 1, 'erfolg': 1, 'installationsprogramm': 1, 'pytho': 1, 'jupyt': 1, 'notebook': 1, 'wissenschaft': 1, 'bibliothek': 1, 'navigator': 1, 'start': 1, 'relational': 2, 'datenbank': 3, 'speich': 1, 'strukturi': 1, 'datum': 1, 'sql': 2, 'verwend': 1, 'abfrag': 1, 'durchfuhr': 1, 'tabell': 1, 'besteh': 1, 'zeil': 1, 'spalt': 1, 'ermog': 1, 'insert': 1, 'updat': 1, 'select': 1, 'operation': 1})
Das Wort 'künstlich' bzw 'kunstlich' kommt also genau 4 Mal im gesamten Wortschatz vor.
Vokabular nach Häufigkeit sortieren und begrenzen
Jetzt wird der gesamte Wortschatz, nach Häufigkeit des Vorkommens der Wörter absteigend sortiert und begrenzt. Hier wird aus didaktischen bzw. der besseren Anschauung wegen der Wortschatz auf nur 15 Wörter insgesamt begrenzt.
Die Größe des Wortschatzes begrenzt dabei die Länge der Liste, also auch die Datenmenge und den damit im Folgenden verbundenen Rechenaufwand. Dabei wird davon ausgegangen, das selten vorkommende Worte weniger relevant sind und so eher abgeschnitten werden dürfen als häufig vorkommende Begriffe, die vorne in der Liste stehen. Wichtige Worte können durchaus sehr selten vorkommen und werden so von der Verarbeitung ausgeschlossen. Dieser Parameter muss also sorgfältig in Abhängigkeit von Rechenleistung bzw. Verarbeitungsdauer angepasst werden.
max_features = 15
vocab = [word for word, freq in word_freq.most_common(max_features)]
vocab
['informat', 'anaconda', 'kunstlich', 'intelligenz', 'zuruck', 'ubersicht', 'installation', 'datenbank', 'enthalt', 'relational', 'sql', 'webseit', 'drei', 'themat', 'unterseit']
Bag of Words erstellen
Die mathematische Verarbeitung von Worten ist direkt nicht möglich. Sie müssen erst in Zahlen umgewandelt werden. Dafür wird die sogenannte Bag Of Words erstellt:
Jeder Text wird zu einem Vektor gemacht. In dem sein Vorkommen vor diesem Gesamtwortschatz abgebildet wird. Es entstehen 4 Vektoren × 15 Dimensionen.
def bag_of_words(tokens, vocab):
    vector = np.zeros(len(vocab))
    for i, word in enumerate(vocab):
        vector[i] = tokens.count(word)
    return vector

bag_matrix = np.array([bag_of_words(doc, vocab) for doc in processed_docs])
bag_matrix
array([[1., 0., 0., 0., 0., 0., 0., 0., 1., 0., 0., 1., 1., 1., 1.],
       [2., 0., 4., 4., 1., 1., 0., 0., 0., 0., 0., 0., 0., 0., 0.],
       [1., 5., 0., 0., 1., 1., 3., 0., 1., 0., 0., 0., 0., 0., 0.],
       [1., 0., 0., 0., 1., 1., 0., 3., 0., 2., 2., 0., 0., 0., 0.]])
Im 2. Text kommt so z.B. das Wort 'kunstlich' und 'intelligenz' jeweils 4x vor.
TF-IDF berechnen
Die Bag Of Words sind hier Listen mit 15 Elementen und jede stellt einen Vektor im 15-dimensionalen Raum dar. Im folgenden werden solche Vektoren miteinander mathematisch verglichen, um Ähnlichkeiten berechnen zu können.
Inverse Document Frequency
Bevor der Vergleich des Such-Bag Of Words mit den Bag Of Words jeder Seite vorgenommen wird, muss die Relevanz der Worte berücksichtigt werden, die in den Bag Of Words abgebildet werden:
Begriffe, die auf jeder Seite vorkommen sind nicht relevant. Diejenigen Worte, die nur auf einzelnen Seiten vorkommen, sind für eine Suchfunktion viel aussagekräftiger.
Die Gewichtung der Worte, in den Bags Of Words muss entsprechend angepasst werden. Worte, die in allen Seiten vorkommen werden weniger gewichtet. Begriffe die nur auf wenigen Seiten vorkommen werden stärker gewichtet. Gleichzeitig bleibt es allerdings wichtig, wie oft ein Begriff überhaupt auf einer Seite vorkommt.
TF-IDF steht für Term Frequency Inverse Document Frequency of Records. Ein Term meint hier umgangssprachlich Wort oder Begriff (alles was eine Bedeutung hat).
TF
Die Termhäufigkeit tf (term frequency) beschreibt, wie oft ein Wort in einem Dokument (hier auf einer Seite), bezogen auf die Gesamtanzahl der Worte in diesem Dokument, vorkommt. Je öfter ein Wort auf einem Dokument vorkommt, um so größer ist die Bedeutung für die Suche. Allerdings nimmt die Relevanz auch ab, je mehr Worte diese Dokument enthält:
\( ( Relevanz\ eines\ Wortes\ \sim tf = \frac{Anzahl\ eines\ Wortes\ im\ Dokument}{Gesamtwortzahl\ des\ Dokuments} \)
IDF
Die Dokumentenhäufigkeit df (document frequency) besagt, in wie vielen Dokumenten ein Term vorhanden ist:
\(df = Anzahl\ der\ Dokumente\ in\ denen\ ein\ bestimmtes\ Wort\ vorkommt \)
Die Relevanz eines Wortes ist aber umgekehrt proportional zu df, also der Anzahl der Dokumente, in denen das Wort vorkommt:
\( Relevanz\ eines\ Wortes\ \sim \frac{1}{df} \) (umgekehrt proportional = engl. inverse proportional)
Außerdem ist dabei relevant, wieviele Dokumente es überhaupt gibt N:
\( Relevanz\ eines\ Wortes\ \sim Gesamtzahl\ aller\ Dokumente\ N \)
Aus beiden Schlussfolgerungen ergibt sich die inverse Dokumentenhäufigkeit idf (inverse document frequency) eines Wortes:
\( Relevanz\ eines\ Wortes\ = idf = \frac{N}{df} \)
Kommt ein Wort in allen Dokumenten vor, dann ergibt sich hier der Wert 1. Tatsächlich ist die Relevanz, die Bedeutung für die Suche = 0, denn es ist völlig unbrauchbar. Daher wird der Logarithmus (zur Basis 2) dieses Bruches bestimmt, denn es gilt log(1) = 0. Die Gewichtung geht also gegen 0, wenn ein Wort in vielen Dokumenten vorkommt. Außerdem wird die Relevanz selten vorkommenden Worten etwas gedämpft:
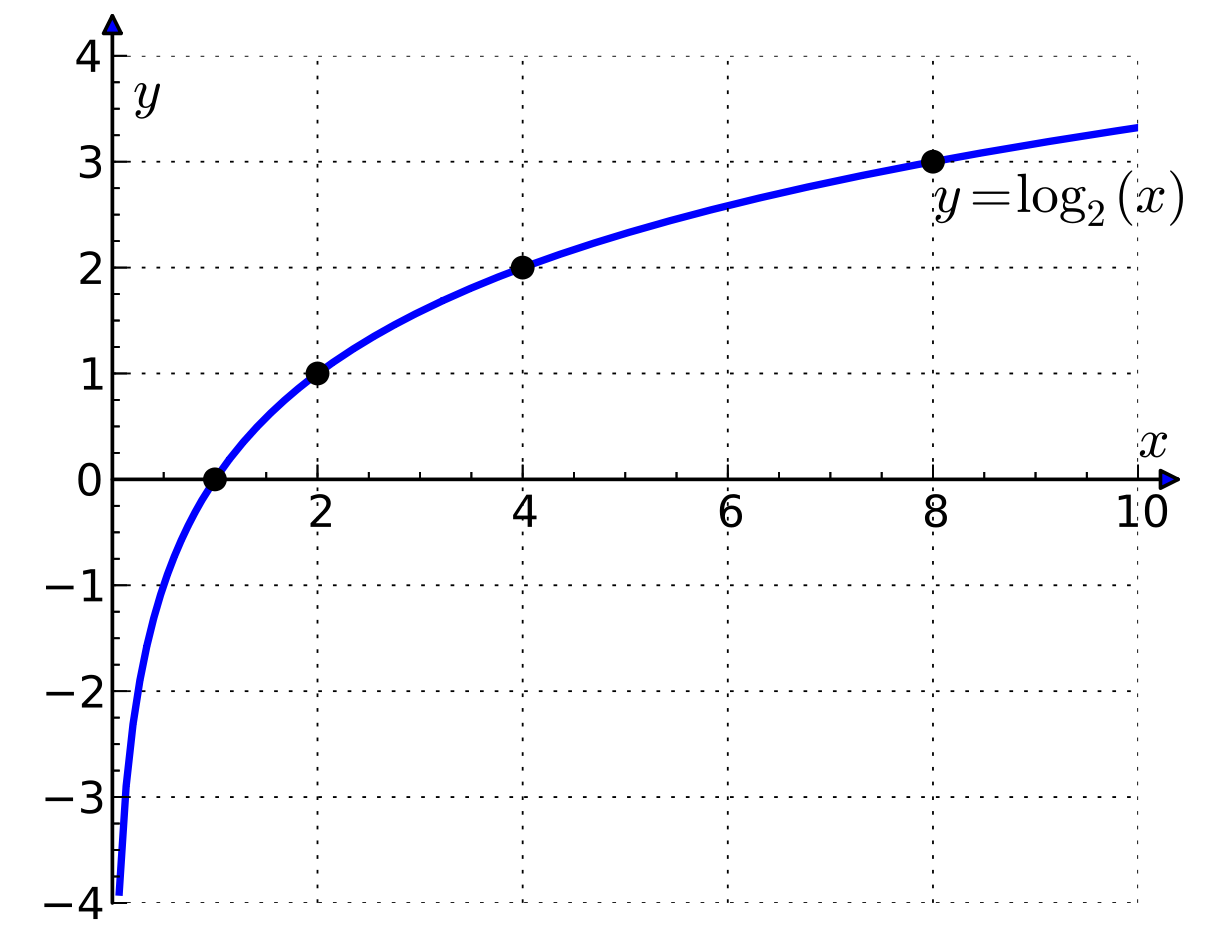
Logarithmusfunktion (zur Basis 2) https://en.wikipedia.org/wiki/Binary_logarithm (12.03.2022)
Beispiel bei :
| df | N/df | log₂(N/df) |
|---|---|---|
| 1000 | 1 | 0 |
| 100 | 10 | 3.32 |
| 10 | 100 | 6.64 |
| 1 | 1000 | 9.97 |
Es muss jedoch außerdem berücksichtigt werden, wie oft ein bestimmtes Wort in einem Dokument vorkommt tf (term frequency). Daher wird zur Berechnung der Relevanz tf mit idf mulitpliziert:
\( tfidf = tf \cdot log_2(\frac{N}{df}) \)
Im Code kann das manuell so programmiert werden. (Die Python-Bibliothek sklearn bietet allerdings auch einen fertigen Algorithmus an.)
N = len(processed_docs)

# df berechnen
df = np.sum(bag_matrix > 0, axis=0)

idf = np.log(N / df)

tfidf_matrix = bag_matrix * idf
tfidf_matrix
array([[0.        , 0.        , 0.        , 0.        , 0.        ,
        0.        , 0.        , 0.        , 0.69314718, 0.        ,
        0.        , 1.38629436, 1.38629436, 1.38629436, 1.38629436],
       [0.        , 0.        , 5.54517744, 5.54517744, 0.28768207,
        0.28768207, 0.        , 0.        , 0.        , 0.        ,
        0.        , 0.        , 0.        , 0.        , 0.        ],
       [0.        , 6.93147181, 0.        , 0.        , 0.28768207,
        0.28768207, 4.15888308, 0.        , 0.69314718, 0.        ,
        0.        , 0.        , 0.        , 0.        , 0.        ],
       [0.        , 0.        , 0.        , 0.        , 0.28768207,
        0.28768207, 0.        , 4.15888308, 0.        , 2.77258872,
        2.77258872, 0.        , 0.        , 0.        , 0.        ]])
Worte, die nur auf wenigen Seiten vorkommen sind nun stärker gewichtet.
Diese Daten könnten gespeichert werden, so dass sie nicht jedes Mal mit Webcrawling und NLP ermittelt werden müssen (Das könnte als zeitgesteuerter Task einmal am Tag erledigt werden. Webcrawler durchlaufen das Netz vorzugsweise, wenn die Netzwerkbelastung gering ist.)
Diese Daten können in einem kompakten binären Format gespeichert werden, da sie nicht für Menschen lesbar sein müssen.
filename = "tfidf.npy"   # Die Dateierweitung muss "npy" sein
np.save(filename,tfidf)  # NumPy enthält Dateifunktionen

Das Lesen der Datei erfolgt mit:

tfidf=np.load(filename)
Suchanfrage verarbeiten
Suchanfragen werden genauso behandelt wie Dokumente:
search = "Anaconda installieren künstlich"

processed_search = process_text(search)
search_vector = bag_of_words(processed_search, vocab)

search_tfidf = search_vector * idf
search_tfidf
array([0.        , 1.38629436, 1.38629436, 0.        , 0.        ,
       0.        , 0.        , 0.        , 0.        , 0.        ,
       0.        , 0.        , 0.        , 0.        , 0.        ])
Kosinus-Ähnlichkeit
Nun wird der Such-Vektor mit allen Seiten-Vektoren verglichen. Dafür wird jeweils die Kosinus-Ähnlichkeit der Vektoren berechnet:
\( cos( \theta )= \frac{ \Sigma{a_i \cdot b_i }}{\sqrt{\Sigma{ a_i^2}} \cdot \sqrt{\Sigma{ b_i^2} }} = \frac{a_1b_1+a_2b_2+...+a_nb_n}{\sqrt{ a_1^2 + a_2^2+...+a_n^2} \cdot \sqrt{ b_1^2 + b_2^2+...+b_n^2}} \)
(Skalarprodukt / Produkt der Vektorlängen)
Werden z.B. zur Veranschaulichung die folgenden Vektoren im zweidimensionalen Raum miteinander verglichen:
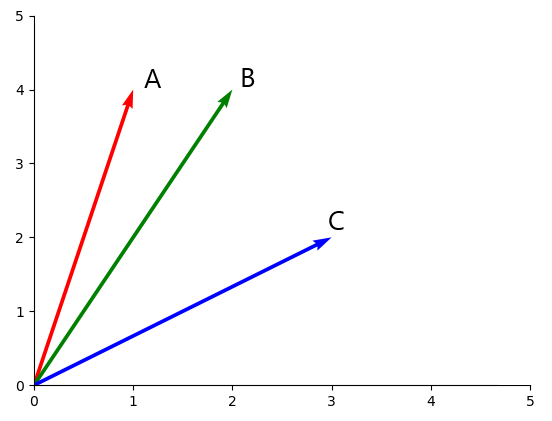
3 Vektoren im zweidimensionalen Raum
Cosine Similarity Explained Using Python | by Misha Sv | Towards Data Science (16.03.2022)
So ergeben die Kosinus-Ähnlichkeiten:
\( Ähnlichkeit(A,B)=cos( \theta )= \frac{1 \cdot 2+4 \cdot 4 }{\sqrt{1^2 +4^2} \cdot \sqrt{ 2^2 + 4^2}}= \frac{18}{ \sqrt{17}} = \frac{18}{4,14} =0,976\\ Ähnlichkeit(A,C) = 0,74 \)
Das bedeutet, dass sich die Vektoren A und B ähnlicher sind als A und C. Je weiter die Ähnlichkeit von cos(θ) gegen 1 geht, um so ähnlicher sind sich zwei Vektoren:
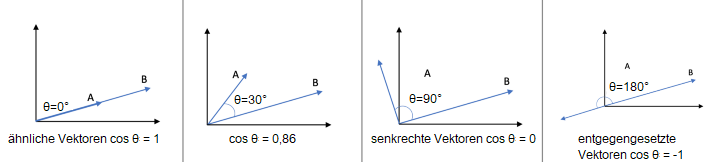
Kosinus-Ähnlichkeit
Der Vergleich wird hier mit einer fertigen Funktion mit 15-dimensionalen Vektoren über das gesamte Array mit einem einzigen Befehl durchgeführt.
from sklearn.metrics.pairwise import cosine_similarity

similarities = cosine_similarity(tfidf_matrix, search_tfidf.reshape(1, -1))
similarities
array([[0.        ],
       [0.49932848],
       [0.60336393],
       [0.        ]])
Der Vergleich liefert eine Liste mit Kosinus-Ähnlichkeiten (Anzahl der Elemente = Anzahl der "gescrapten" Seiten).
Nun wird der Index des höchsten Wertes wird ermittelt. Damit wird der relevanteste Link indiziert.
Das Ergebnis der Suche mit 'Anaconda installieren künstlich' wird ausgegeben:
best_index = similarities.argmax() # liefert den Index des größten Werts in der Liste

print("Am relevantesten ist das " + str(best_index + 1) + ". Dokument:")
print(documents[best_index])

print(urls[best_index])
Am relevantesten ist das 3. Dokument:
Informatik Installation von Anaconda Anaconda ist eine Python-Distribution für Data Science. Die Installation von Anaconda erfolgt über ein Installationsprogramm. Anaconda enthält Python, Jupyter Notebook und viele wissenschaftliche Bibliotheken. Nach der Installation kann Anaconda über den Navigator gestartet werden. Zurück zur Übersicht
https://ateachment.github.io/nlp-demo/anaconda.html
Damit hat sich das relevanteste Suchwort 'Anaconda' hier durchgesetzt, denn 'künstlich' kommt auf der Zielseite gar nicht vor.