
Cache
Bisher waren CPUs immer schneller als der Speicher. In der Praxis muss die CPU viele Taktzyklen warten, bis ein benötigtes Wort aus dem Speicher bereitsteht. Das Problem verschärft sich zunehmend mit den Möglichkeiten von Pipelining und superskalarem Betrieb. Das ist ein wirtschaftliches Problem, weil Speicher umso teurer ist, je schneller er ist.
Mit der Bereitstellung von Cache-Speichern kombiniert man einen kleine schnelle CPU-nahe Speicher mit dem großen langsamen Hauptspeicher und erreicht so (fast) die Geschwindigkeit des schnellen und die Kapazität des großen Speichers.1
Prinzip
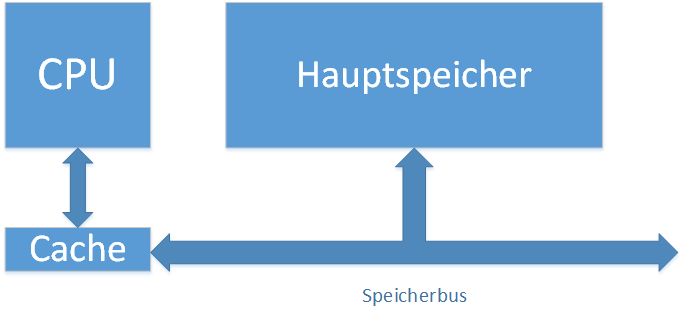 Wenn die CPU ein Wort
benötigt, wird erst im Cache nachgesehen, ob es dort bereitsteht. Im
Falle eines Treffers (Cache Hit) kann schnell darauf zugegriffen
werden, im Falle eines Cache-Fehlschlags (Cache Miss) muss das Wort
erst aus dem Hauptspeicher in den Cache geladen werden.
Lokalitätsprinzip
Ein großer Teil von Befehlen wird in Form von Schleifen abgearbeitet oder die Befehle beziehen sich auf einen bestimmten Speicherbereich (z.B. Arrays). Die Speicherzugriffe beziehen sich also innerhalb kürzerer Zeitintervalle häufig auf die gleichen, kleineren Bereiche des Speichers (räumliche Lokalität). Dieses sogenannte Lokalitätsprinzip macht sich das Caching zu Nutze, indem der Cache in Cache-Zeilen mit z.B. 32 Bytes Länge unterteilt wird. Im Falle eines Cache-Fehlschlags wird nicht nur das Wort, sondern die gesamte Cache-Zeile auf einmal neu geladen, weil die Wahrscheinlichkeit sehr hoch ist, dass die folgenden 28 Bytes ebenfalls in Kürze benötigt werden. Diese Vorgehensweise ist erstens schneller als einzelne Wörter nach Bedarf nachzuladen und zweitens ist der erforderliche Verwaltungsaufwand in Folge der geringere Anzahl von Einträgen geringer.
Schreiboperationen
Wurde ein Datenwort im
Cache verändert, muss diese Aktualisierung auch im Speicher
erfolgen.
Auch wenn ein Datenwort verändert werden soll, dass sich nicht im Cache befindet, stellt sich die Frage, ob die Änderung direkt in den Speicher geschrieben werden soll oder ob man die betreffende Zeile in den Cache holt, dort verändert und für weitere Zugriffe im Cache vorhält.
Die meisten Designs mit Durchschreibe-Verfahren setzen auf die direkte Manipulation des Speichers. Diejenigen Designs, die das komplexere Verfahren des Write Deferred nutzen, holen das Wort zunächst in den Cache.
Cache-Level
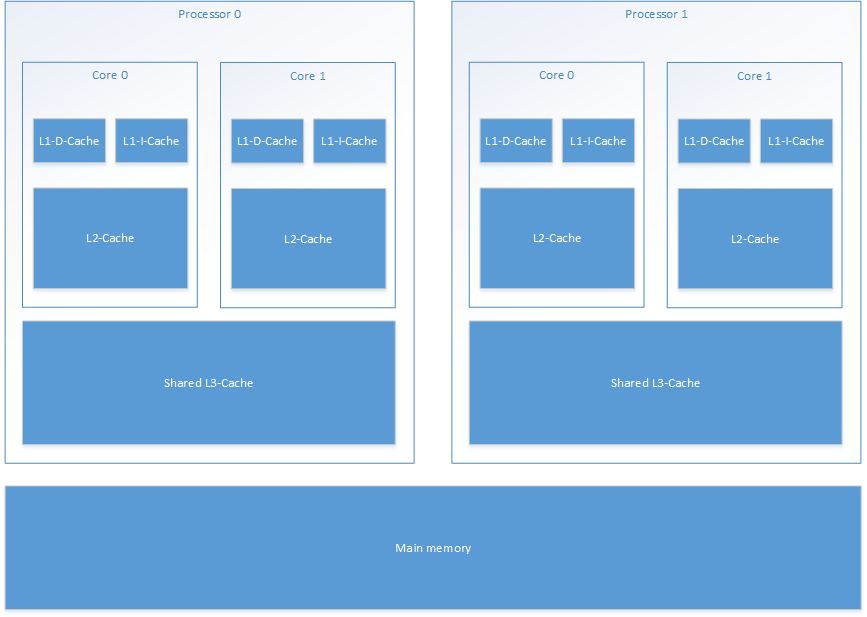
Cache ist in verschiedene Ebenen aufgliedert, in sogenannte Cache-Level. Im kleinen L1-Cache (kB-Bereich) legen die meisten CPUs Daten und Befehlssequenzen in zwei getrennten Bereichen ab. Das erleichtert die Organisation des Zwischenspeichers und sorgt in der Regel für eine zügige Versorgung der Rechenregister mit Daten und abzuarbeitenden Befehlen.
Eine nächste Ebene bildet der deutlich größere L2-Cache (3-stelliger kB-Bereich). Er hält gemeinsam Daten und Befehle.
Moderne Prozessoren enthalten mehrere Rechenkerne -
sogenannte Cores. Diese greifen gemeinsam auf den L3-Cache zu (2-stelliger MB-Bereich). So können auch Daten, die von
unterschiedlichen CPU-Kernen gemeinsam bearbeitet werden aus dem
schnellen L3-Cache geholt werden. Ohne ihn müssten diese Daten immer aus
dem langsamen Hauptspeicher kommen.
1 Computerarchitektur. Strukturen, Konzepte, Grundlagen: Tanenbaum, A.S.; Goodman, J. Prentice Hall, 4. Aufl. 1999, S. 92ff.